JEV im Praxistest: Kein LLM-Killer, aber ein schneller Spezialist
JEV sortiert Geschäfts-E-Mails ähnlich treffsicher wie GPT-6 Luna, antwortet aber viermal so schnell und ist rund 47 % günstiger. Ein Praxistest mit 450 E-Mails, offenem Code und nachvollziehbaren Zahlen.
Meine Einschätzung vorweg: JEV wird die großen Sprachmodelle nicht ablösen. Für Klassifizierungsaufgaben, also klar umrissene Entscheidungen, ist es aber eine ernsthafte Alternative. Ich erwarte, dass für solche Aufgaben schnelle, günstige Spezialmodelle zum Standard werden, ob von TypeSafe, von OpenAI oder aus der Open-Weight-Welt. OpenAI hat mit der Decisions API bereits ein direktes Gegenstück angekündigt.
Zwei Wochen Hype
Am 15. September 2026 hat das Start-up TypeSafe AI JEV vorgestellt: ein Modell, das keinen Text schreibt. Man stellt ihm Fragen mit festen Antwortoptionen, und es wählt eine davon aus.
Das Interesse war groß. Nach Angaben von Vercel setzten über dessen AI Gateway, einen Dienst, über den Entwickler KI-Modelle verschiedener Anbieter ansprechen, in den ersten 24 Stunden mehr als doppelt so viele zahlende Teams JEV ein wie bei jedem früheren Modellstart. TypeSafe verspricht 40- bis 200-mal schnellere Antworten als Frontier-LLMs, zu einem Bruchteil der Kosten.
Unabhängige Messungen habe ich zum Start nicht gefunden. Also habe ich selbst nachgemessen, an einer Aufgabe, die jeder kennt: Welche E-Mail muss ich sofort bearbeiten, und welche kann warten? Weil JEV für Klassifizierung gebaut ist, habe ich es nicht gegen die großen Frontier-Modelle antreten lassen, sondern gegen eine naheliegende Alternative dafür: kleine, schnelle Sprachmodelle.
Was JEV anders macht
JEV beantwortet Fragen, die man vorher festlegt, statt Text zu generieren. TypeSafe nennt das ein „System-One-Modell“: schnell und intuitiv, wie das schnelle Denken bei Kahneman.
Man schickt einen Zustand, zum Beispiel eine E-Mail, und typisierte Fragen. Etwa: „Wie dringend ist das? sofort / bald / später“ oder „Ist das Phishing? ja/nein“. Zurück kommen die Antworten mit Wahrscheinlichkeiten, alle Fragen in einem einzigen Aufruf.
TypeSafe wirbt damit, dass JEV nicht halluziniert. Gemeint ist, dass die Antwort immer zum vorgegebenen Schema passt. Eine inhaltlich falsche Wahl ist trotzdem möglich. In meinem Test gab es keine einzige ungültige Antwort, allerdings auch nicht bei Luna und Haiku, denen ich das Antwortformat ebenfalls vorgegeben habe. Ob JEV immer gleich antwortet und wie oft es richtig liegt, habe ich deshalb separat gemessen.
Der Test: 450 E-Mails, vier Entscheidungen
Jedes Modell trifft pro E-Mail vier Entscheidungen in einem Aufruf: Dringlichkeit (sofort / bald / später), Kategorie (sechs Klassen), Antwort nötig (ja/nein) und Phishing-Verdacht (ja/nein).
- 300 echte E-Mails aus meinem privaten Gmail-Postfach. Bevor sie an eine API gingen, habe ich sie lokal pseudonymisiert: Erkannte Personennamen, private Adressen und Telefonnummern wurden ersetzt, Links auf ihre Domain gekürzt. Organisationsnamen und Absender-Domains blieben erhalten, weil sie für die Klassifizierung wichtig sind. Geprüft habe ich das per Stichprobe.
- 150 synthetische Geschäfts-E-Mails mit deutlich breiter gestreuten Klassen als im privaten Postfach, darunter versteckte Fristen, Werbung mit falschem Zeitdruck und 24 Phishing-Versuche. Geschrieben haben sie abwechselnd GPT-6 Sol, Claude Opus 5.5 und Gemini 3.8 Flash. Echte dienstliche E-Mails habe ich aus Datenschutzgründen nicht verwendet.
- Die Referenzlabels („Ground Truth“) stammen von denselben drei Modellen per Mehrheitsentscheid. Die vier Fälle ohne Mehrheit habe ich selbst entschieden. Gemessen wird also die Übereinstimmung mit dieser Referenz, nicht mit einer von Menschen geprüften Musterlösung.
- Die Kandidaten: JEV 1.13.0 gegen zwei schnelle, günstige LLMs, GPT-6 Luna (ohne Reasoning) und Claude Haiku 4.5. JEV lief zusätzlich mit deutsch statt englisch formulierten Fragen, die Hauptergebnisse beziehen sich auf die englischen. Jede E-Mail lief zweimal, die Anfragen eines Modells nacheinander, damit die Latenz sauber messbar bleibt.
Der gesamte Test hat laut Abrechnung rund 10 Euro gekostet, fast alles für die großen Prüfer-Modelle. JEV selbst kostete für 1.811 Anfragen knapp 10 US-Cent, das deckt sich auf den Cent mit TypeSafes Abrechnung.
Die Ergebnisse: ähnlich gut, viel schneller
Alle Zahlen in diesem Abschnitt beziehen sich auf die 150 synthetischen Geschäfts-E-Mails. Die Kosten sind aus den gemeldeten Tokens und den Listenpreisen berechnet. JEV erreicht eine ähnliche Trefferquote wie GPT-6 Luna, antwortet aber viermal so schnell und ist rund 47 % günstiger.
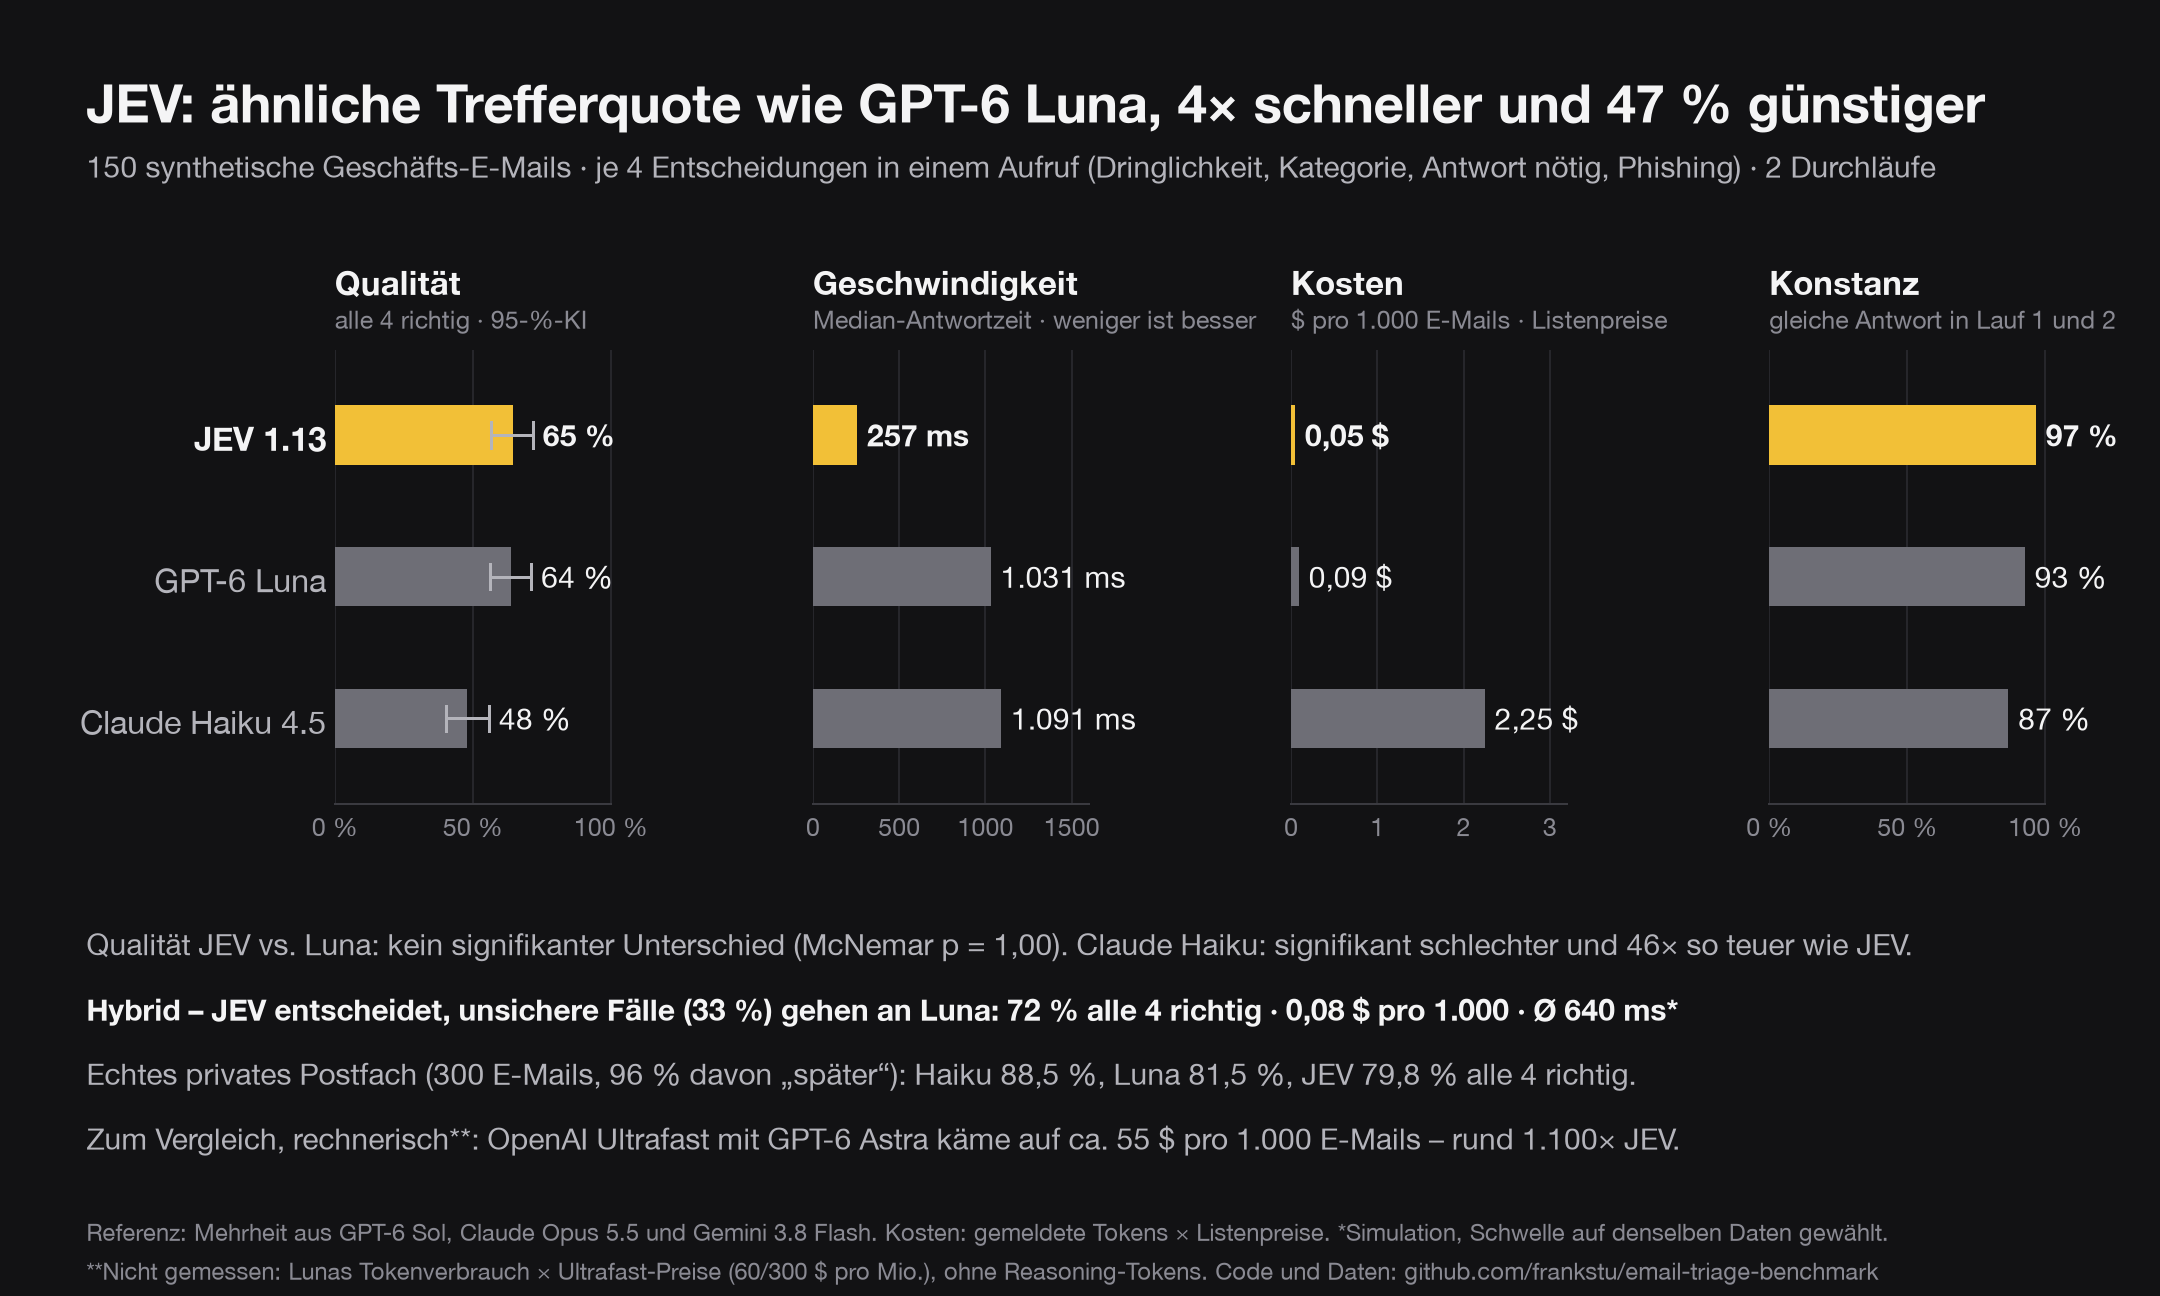
Über beide Läufe lag JEV bei 65 % der E-Mails in allen vier Entscheidungen richtig, Luna bei 64 %. Im ersten Lauf waren es 97 gegenüber 96 von 150 E-Mails. Dieser Unterschied lässt sich statistisch nicht von Zufall trennen (McNemar-Test, p = 1,0). Bewiesen ist damit nicht, dass beide gleich gut sind, nur dass der Test keinen Unterschied findet. Claude Haiku kam auf 48 % und liegt klar dahinter, auch statistisch.
Für die Praxis zählt aber auch, welche Fehler passieren. Von den E-Mails, die sofort bearbeitet werden müssen, erkannte JEV 87 %, Luna 92 % und Haiku 97 %. Haiku stufte dafür auch deutlich mehr E-Mails fälschlich als „sofort“ ein. Von den 24 Phishing-Versuchen übersahen JEV und Luna im Schnitt jeweils vier pro Lauf.
Bei der Antwortzeit lag JEV im Median bei 257 Millisekunden, Luna bei gut einer Sekunde (1.031 ms) und Haiku knapp darüber (1.091 ms). Pro 1.000 E-Mails kostete JEV knapp 5 US-Cent, Luna gut 9 Cent und Haiku 2,25 Dollar. Bei einer Million E-Mails im Monat wären das rund 49, 92 und 2.250 Dollar. Bei JEV zahlt man dabei nur für die Eingabe, Output-Tokens sind kostenlos.
TypeSafe selbst verspricht 40- bis 200-mal schnellere Antworten. Dafür stellt der Hersteller JEVs 70 bis 500 Millisekunden den dokumentierten Antwortzeiten von Frontier-LLMs gegenüber, 3 bis 329 Sekunden. In der Demo tritt GPT-5.6 Terra mit Standard-Reasoning an. Gegen kleine, schnelle Modelle war JEV in meinem Test viermal schneller. Gegen die drei großen Prüfer-Modelle lag der Faktor bei 8 bis 15: GPT-6 Sol mit mittlerem Reasoning-Aufwand brauchte im Median 2,1 Sekunden, Claude Opus 5.5 2,4 und Gemini 3.8 Flash 3,9 Sekunden, beide mit Standardeinstellungen.
Auch bei der Konstanz liegt JEV auf den Geschäfts-E-Mails vorn. Bei identischer Eingabe kamen in 97 % der Fälle zweimal dieselben vier Entscheidungen heraus, bei Luna in 93 %, bei Haiku in 87 %. Im privaten Postfach lagen Luna (99,0 %) und JEV (98,7 %) praktisch gleichauf.
TypeSafe nennt Englisch als Hauptsprache, in der JEV am genauesten ist. In meinem Test waren die meisten E-Mails deutsch, und JEV lag trotzdem nahe an Luna. Mit deutsch formulierten Fragen kam JEV auf 61,7 % statt 65,3 %, statistisch ist dieser Unterschied nicht gesichert (p = 0,58). Ob JEV bei englischen E-Mails besser abschneiden würde, kann ich nicht sagen: Dafür waren nur 19 der 150 E-Mails englisch.
Was die Zahlen nicht sagen
Im echten privaten Postfach sieht das Bild anders aus: Dort lag Claude Haiku mit 88,5 % vorn, Luna kam auf 81,5 % und JEV auf 79,8 %. Allerdings waren 93 % dieser E-Mails Newsletter, Werbung oder Benachrichtigungen. Bei der Dringlichkeit traf schon die simple Regel „immer später“ 96 %. Luna (97,5 %) und Haiku (96,5 %) lagen knapp darüber, JEV (95,0 %) knapp darunter. Nur vier E-Mails mussten sofort bearbeitet werden, Phishing kam gar nicht vor. Wie gut ein Modell solche seltenen, aber wichtigen Fälle erkennt, lässt sich am privaten Postfach also kaum beurteilen.
- Luna und Haiku liefen über Langdock mit EU-Hosting, JEV direkt bei TypeSafe in den USA. Die Antwortzeiten enthalten damit auch unterschiedliche Netzwerkwege und Infrastruktur. Wie viel das ausmacht, habe ich nicht getrennt gemessen.
- Haiku 4.5 ist ein Jahr älter als Luna. Außerdem musste ich das Antwortformat bei Claude über einen Tool-Aufruf erzwingen, was zusätzliche Tokens kostet.
- Die Anweisung an die LLMs spricht von „meinem privaten Postfach“, auch bei den Geschäfts-E-Mails. Und Kategorien wie „persönlich“ und „Termin“ überschneiden sich teilweise. Beides lässt sich nur mit einem neuen Messlauf beheben.
- Die Referenzlabels sind nicht perfekt. Bei der Dringlichkeit waren sich die drei Prüfer-Modelle nur bei 91 von 150 E-Mails vollständig einig. Dazu kommt: Dieselben Modelle haben die synthetischen E-Mails geschrieben und bewertet. Einen Vorteil für die eigene Modellfamilie konnte ich aber nicht feststellen. Luna schnitt zum Beispiel bei den E-Mails von Opus am besten ab, nicht bei denen von Sol.
- Mit 150 E-Mails bleiben die Schätzungen ungenau, kleinere Unterschiede können unentdeckt bleiben. Das 95-%-Konfidenzintervall für JEV im ersten Lauf reicht von 57 % bis 72 %, und mögliche Fehler in den Referenzlabels sind darin noch nicht enthalten.
- Der Faktor 8 bis 15 gegenüber den Prüfer-Modellen ist nur ein grober Vergleich. Sie liefen mit zwei parallelen Anfragen und nicht unter denselben Bedingungen wie der eigentliche Benchmark.
- Ob JEV wirklich Frontier-Niveau erreicht, wie TypeSafe schreibt, kann mein Test nicht fair beantworten. Die Frontier-Modelle haben die Referenz schließlich selbst festgelegt.
- Pseudonymisierung ist keine Anonymisierung. Inhalte, Organisationsnamen und Domains können weiter Rückschlüsse erlauben. Wer sensible E-Mails an eine API schicken will, muss das gesondert prüfen.
Was das für die großen Anbieter bedeutet
Ein Ersatz für Sprachmodelle ist JEV nicht. Es beantwortet keine E-Mail, fasst nichts zusammen und schreibt keinen Code. Es wählt zwischen Optionen, die man vorher festgelegt hat.
Bei genau dieser Art von Aufgaben stehen die großen Anbieter aber unter Preis- und Geschwindigkeitsdruck. Eine Woche nach dem JEV-Start brachte OpenAI GPT-6 Sol und GPT-6 Luna heraus, zu etwa halben Preisen ihrer Vorgänger aus der GPT-5.6-Reihe. Luna kostet 0,10 Dollar pro Million Input-Tokens und 0,50 Dollar pro Million Output-Tokens. Ob der Zeitpunkt mit JEV zu tun hat, weiß ich nicht. Auch Open-Weight-Modelle wie DeepSeek oder Xiaomis MiMo setzen die Preise unter Druck. In meinem Test lag Luna bei der Qualität nahe an JEV und war rund 1,9-mal so teuer.
Der direktere Konter kam am 29. September: Auf dem DevDay stellte OpenAI die Decisions API vor. Sie nutzt Luna für Entscheidungen zwischen vorgegebenen Antworten, etwa zum Klassifizieren, zum Routing oder um den nächsten Schritt eines Agenten zu wählen. Das ist im Kern JEVs Ansatz, jetzt auch bei OpenAI. Bisher ist sie nur in einer begrenzten Vorschau verfügbar, einen Preis hat OpenAI noch nicht genannt. Getestet habe ich sie noch nicht. Ein Vergleich mit JEV wäre der naheliegende nächste Test.
Warum Geschwindigkeit hier so zählt: Eine Viertelsekunde statt einer Sekunde klingt nach wenig. Ein Agent, der zehn solcher Entscheidungen nacheinander trifft, käme bei diesen Antwortzeiten aber rechnerisch auf 2,5 statt 10 Sekunden reine Wartezeit auf das Modell.
Am selben Tag führte OpenAI außerdem einen Ultrafast-Modus ein, allgemein verfügbar für das Spitzenmodell GPT-6 Astra und als Vorschau für GPT-5.6 Sol. Laut OpenAI erzeugt er in der API bis zu sechsmal schneller Tokens, kostet aber auch das Sechsfache: 60 Dollar pro Million Input-Tokens und 300 Dollar pro Million Output-Tokens. EU-Verarbeitung gibt es dafür nicht. Gemessen habe ich Ultrafast nicht. Mit Lunas Tokenverbrauch aus meinem Test wären es rechnerisch rund 55 Dollar pro 1.000 E-Mails, wie viele Tokens Astra selbst bräuchte, weiß ich nicht. Für Aufgaben wie meine ist das keine Alternative.
Eine offene Alternative gibt es auch: Drei Tage nach JEV veröffentlichte Convai Innovations mit Laya ein Modell mit ähnlicher Entscheidungsschnittstelle, das lokal läuft. Für sensible Daten wie dienstliche E-Mails ist das ein großer Vorteil. Auf dem Benchmark der Entwickler kam eine eigens nachtrainierte Variante auf 76,6 %, JEV auf 72,7 %. Die JEV-Werte haben die Entwickler allerdings aus fremden Messungen übernommen. Das Basismodell erreichte ohne Anpassung nur 36,2 % und lag damit unter der simplen Regel, immer die häufigste Antwort zu wählen (46,1 %). Ohne eigenes Training geht es also nicht. Selbst getestet habe ich Laya noch nicht.
Wo JEV heute Sinn ergibt
Einen Test wert ist JEV dort, wo viele gleichartige Entscheidungen schnell fallen müssen, zum Beispiel bei:
- großen Mengen von Tickets, E-Mails, Formularen oder Inhalten, die vorsortiert werden sollen
- Aufgaben mit festen Kategorien, bei denen die möglichen Antworten vorher feststehen
- Entscheidungen, auf die jemand wartet, etwa beim Routing in Agenten oder bei der Moderation
Ob es für den produktiven Einsatz reicht, hängt davon ab, wie viele Fehler man sich leisten kann. Gerade bei Phishing oder Moderation ist Tempo allein kein Argument.
Interessant wird es in Kombination. JEV liefert zu jeder Antwort einen Konfidenzwert. In einer nachträglichen Simulation mit den Daten des ersten Laufs habe ich alle E-Mails unterhalb einer Konfidenzschwelle an Luna weitergegeben. Die Trefferquote stieg dadurch von 65 % auf 72 %, mehr als jedes der beiden Modelle allein. Weitergeleitet wurde ein Drittel der E-Mails, die Kosten lagen bei 0,08 Dollar pro 1.000.
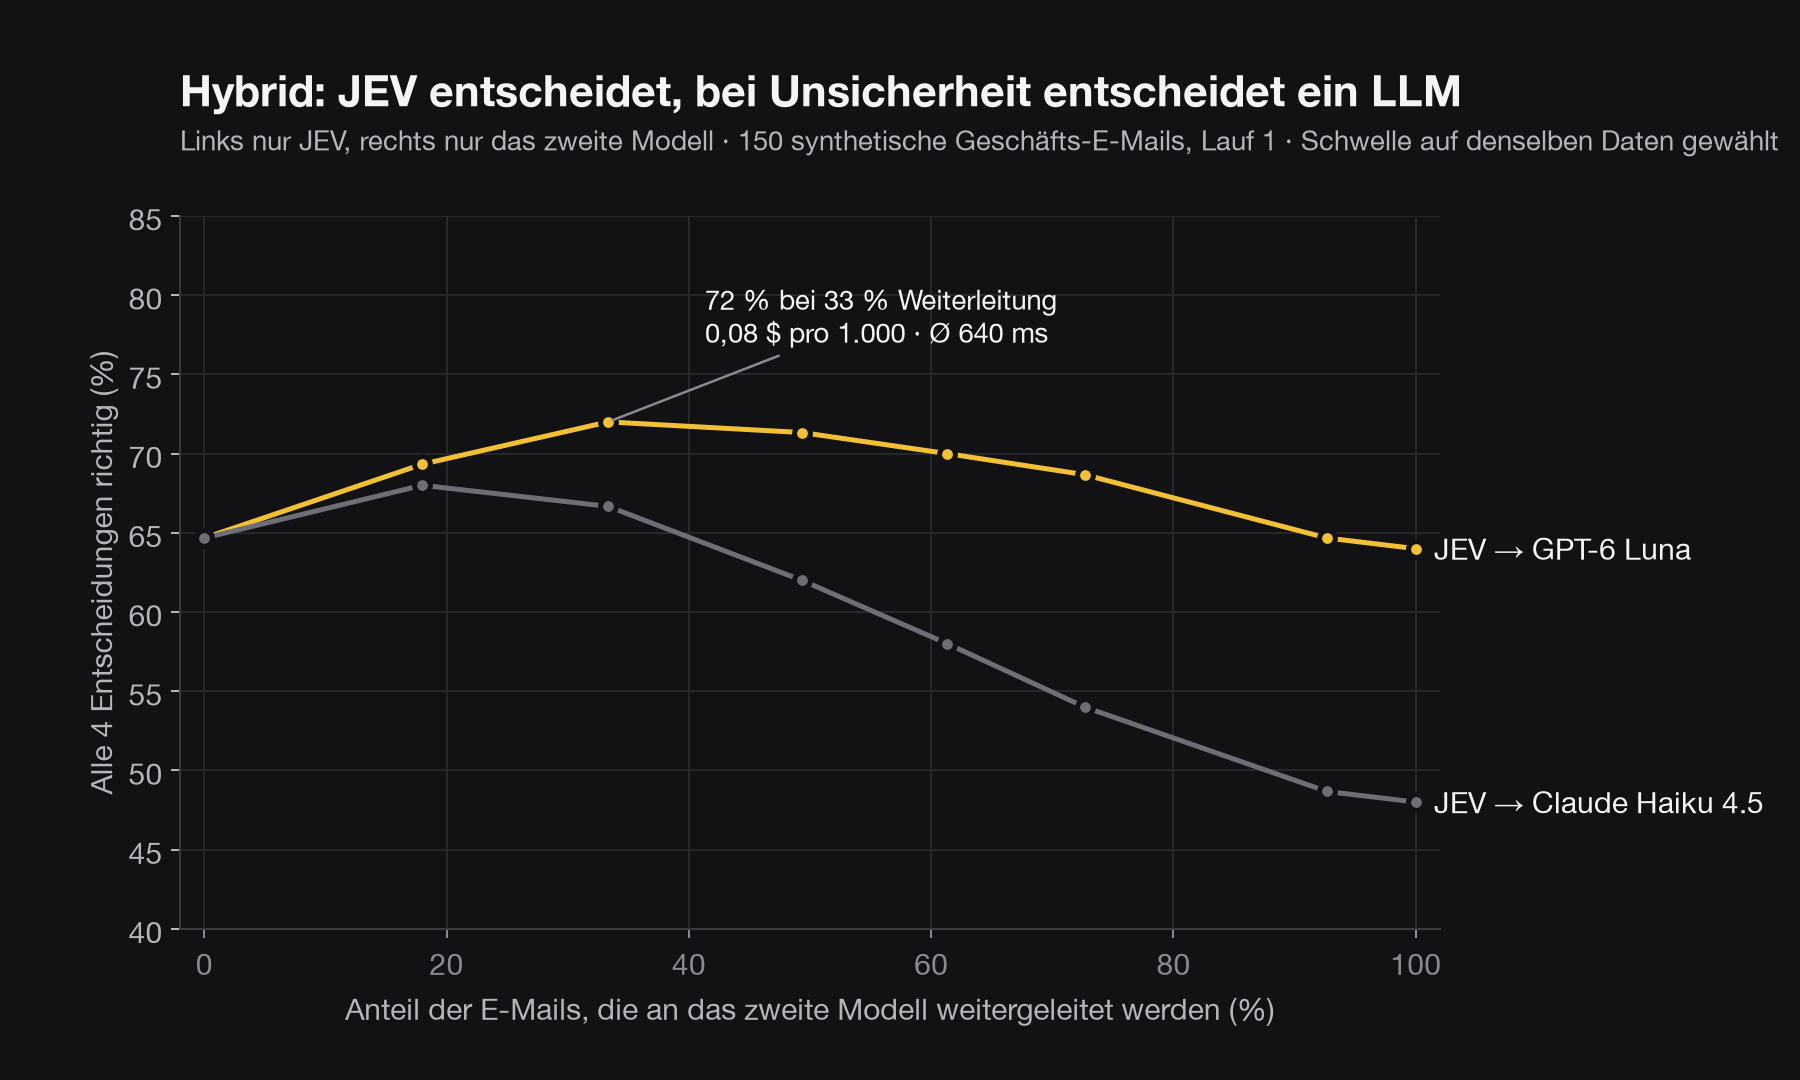
Ein Vorbehalt: Die Schwelle habe ich auf denselben Daten gewählt, auf denen ich messe. Der Gewinn kann deshalb überschätzt sein. Ob er bei neuen E-Mails bleibt, müsste ein eigener Test zeigen.
Fazit
Bei klar umrissenen Entscheidungen hat JEV in meinem Test auf den Geschäfts-E-Mails eine ähnliche Trefferquote wie GPT-6 Luna erreicht, bei viermal kürzerer Antwortzeit, rund 47 % niedrigeren Kosten und beständigeren Antworten. Die 40- bis 200-fachen Geschwindigkeitsvorteile aus TypeSafes Werbung gelten gegenüber großen Modellen, nicht gegenüber kleinen. Die großen Sprachmodelle löst JEV nicht ab, weil es keinen freien Text erzeugt. Dass OpenAI mit der Decisions API so schnell nachzieht, zeigt aber, wie ernst die großen Anbieter diese Art von Modell nehmen.
Code, synthetische Daten, Einzelmessungen und alle Kennzahlen liegen offen auf GitHub. Wer den Test mit eigenen E-Mails wiederholen möchte, findet dort auch die lokale Pseudonymisierung.
Wie seht ihr das: Wo würdet ihr ein Entscheidungsmodell wie JEV einsetzen, und wo bleibt ihr beim LLM?
Aktualisiert am 2. Oktober 2026: OpenAIs Preisangaben korrigiert (neue Modelle statt Preissenkung), Decisions API ergänzt, Angaben zum privaten Postfach, zu den Kosten und zur Fragesprache korrigiert, Methodik genauer beschrieben.
Quellen
- TypeSafe AI: Introducing System One Models and Jev
- TypeSafe AI: Modelle, Sprachen und Preise
- TypeSafe AI: API-Dokumentation
- Vercel: Jev-Start im AI Gateway
- OpenAI: Introducing GPT-6 Sol and Luna
- Cryptonomist: OpenAI GPT-6 Pricing
- OpenAI: DevDay 2026 Recap (Decisions API, Ultrafast)
- OpenAI: Ultrafast-Modus, Dokumentation
- Mixed News: GPT-6 Astra Ultrafast
- Convai Innovations: Laya auf Hugging Face
- Benchmark-Repository, Ergebnisübersicht, Kennzahlen